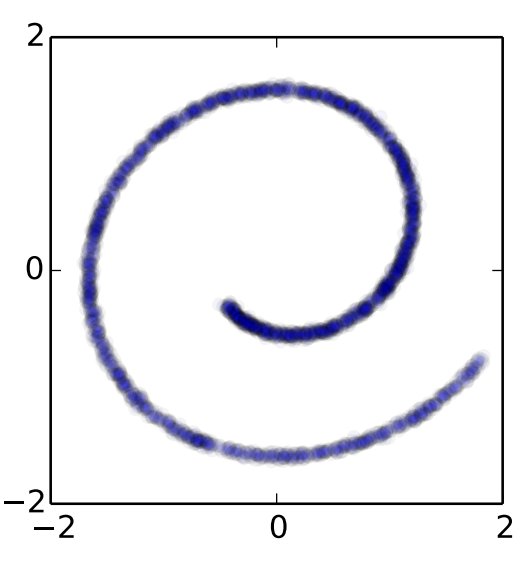
Los modelos de difusión operan perturbando LA DISTRIBUCIÓN para luego aprenderla. Y cuando aprende esa distribución, de ella pueden sacar imágenes totalmente nuevas. Esa es la base de cualquier modelo que se haga llamar "generativo". Y eso es lo que muestra la figura del espiral
MACHINE LEARNING
-
Understanding Datasets: Each Point Represents One Image
By
–
Es decir, esa imagen de un espiral NO representa a una sola imagen (un datapoint del dataset) sino que ese espiral sería un hipotético dataset al completo, donde cada punto que veis sería UNA IMAGEN. Una imagen, o una canción, un vídeo o una proteina. Un datapoint, vamos.
-
Data Distribution Problem in AI Diffusion Models
By
–
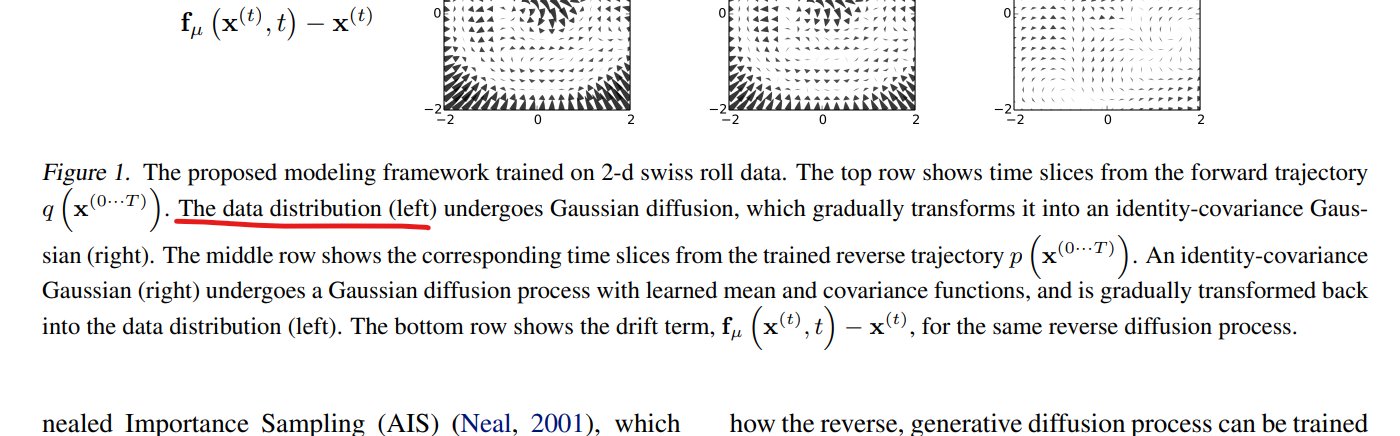
El problema es que lo que esa figura presenta, y donde se equivocan ellos, no es el proceso de difusión de una única imagen (la del espiral) que se destruye y se recupera en una copia casi exacta. Sino la DISTRIBUCIÓN DE LOS DATOS
-
Diffusion Models: The 2015 Paper That Changed Deep Learning
By
–
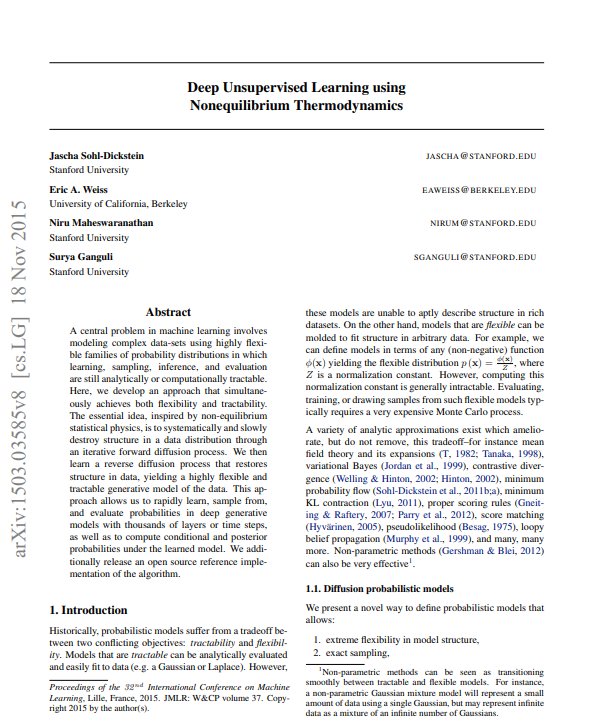
Esa figura que presentan para explicar su problema con esta tecnología proviene del paper de 2015 que introdujo en el mundo del Deep Learning la idea de los modelos de difusión. Este trabajo de aquí [LINK: https://
arxiv.org/pdf/1503.03585
.pdf
…] -
MIT OpenCourseWare: Free CS, AI and Algorithms Courses
By
–
Free MIT videos & online materials from more than 2,400 courses, including intro classes in computer science, AI and algorithms. Browse our open CS courses here: https://
bit.ly/39jH8DV (v/
@MITOCW
) -
Training a 10M Parameter GPT Model on Shakespeare in 15 Minutes
By
–
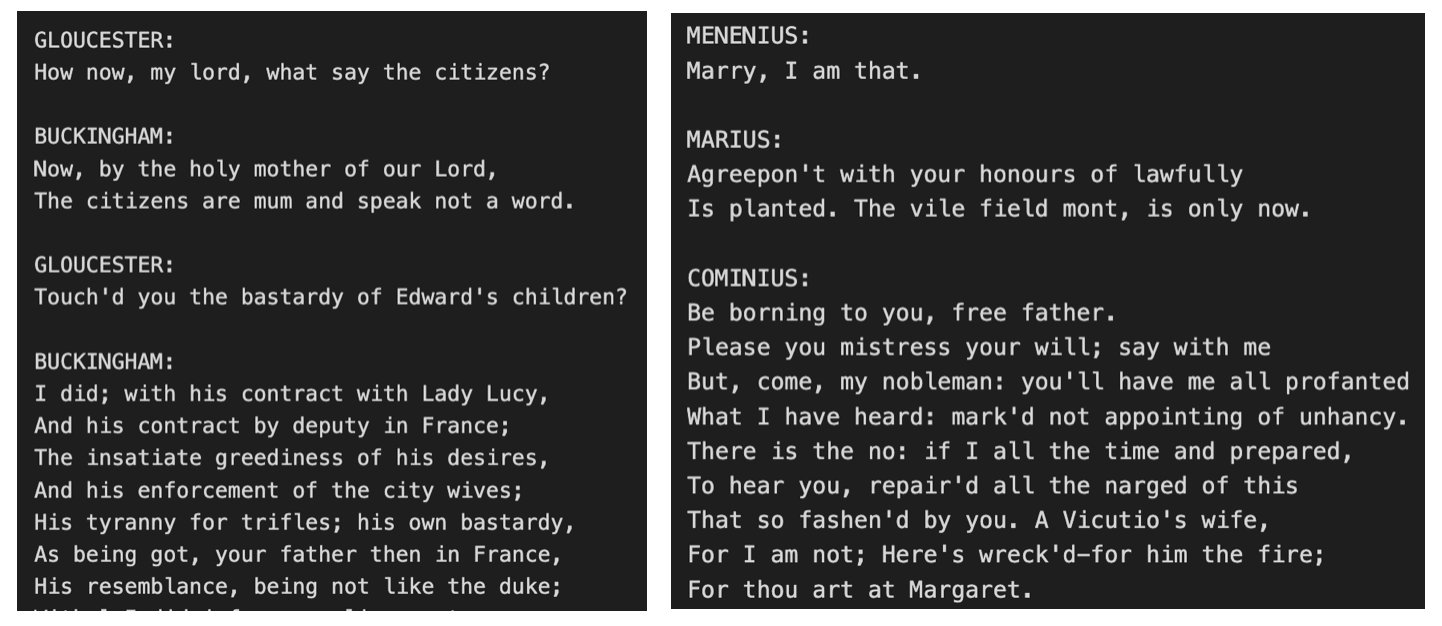
We get a ~10M parameter model trained for about 15 minutes on 1 GPU on all of Shakespeare concatenated into one 1MB file. We then sample infinite fake Shakespeare from our baby GPT. Can you spot which one is real? At only 10M params on 1M characters, from-scratch, I hope so 🙂
-

Building Transformers: Self-Attention, Training, and GPT-3 Comparison
By
–
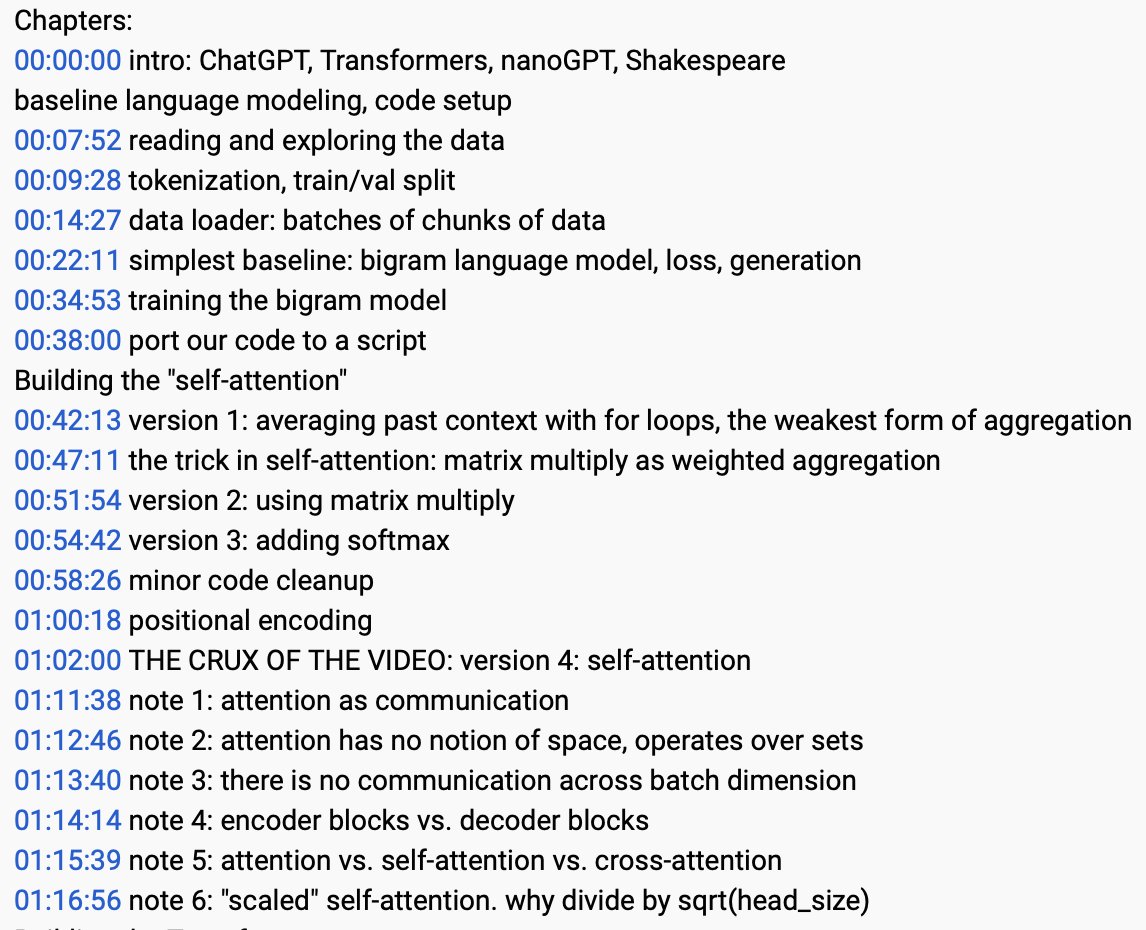
The second ~1hr builds up the Transformer: multi-headed self-attention, MLP, residual connections, layernorms. Then we train one and compare it to OpenAI's GPT-3 (spoiler: ours is around ~10K – 1M times smaller but the ~same neural net) and ChatGPT (i.e. ours is pretraining only)
-
Transformer Attention Mechanism: Baseline Model and Message Passing Introduction
By
–
First ~1 hour is 1) establishing a baseline (bigram) language model, and 2) introducing the core "attention" mechanism at the heart of the Transformer as a kind of communication / message passing between nodes in a directed graph.
-
Happy Birthday NeRF: Celebrating Deep Learning History
By
–
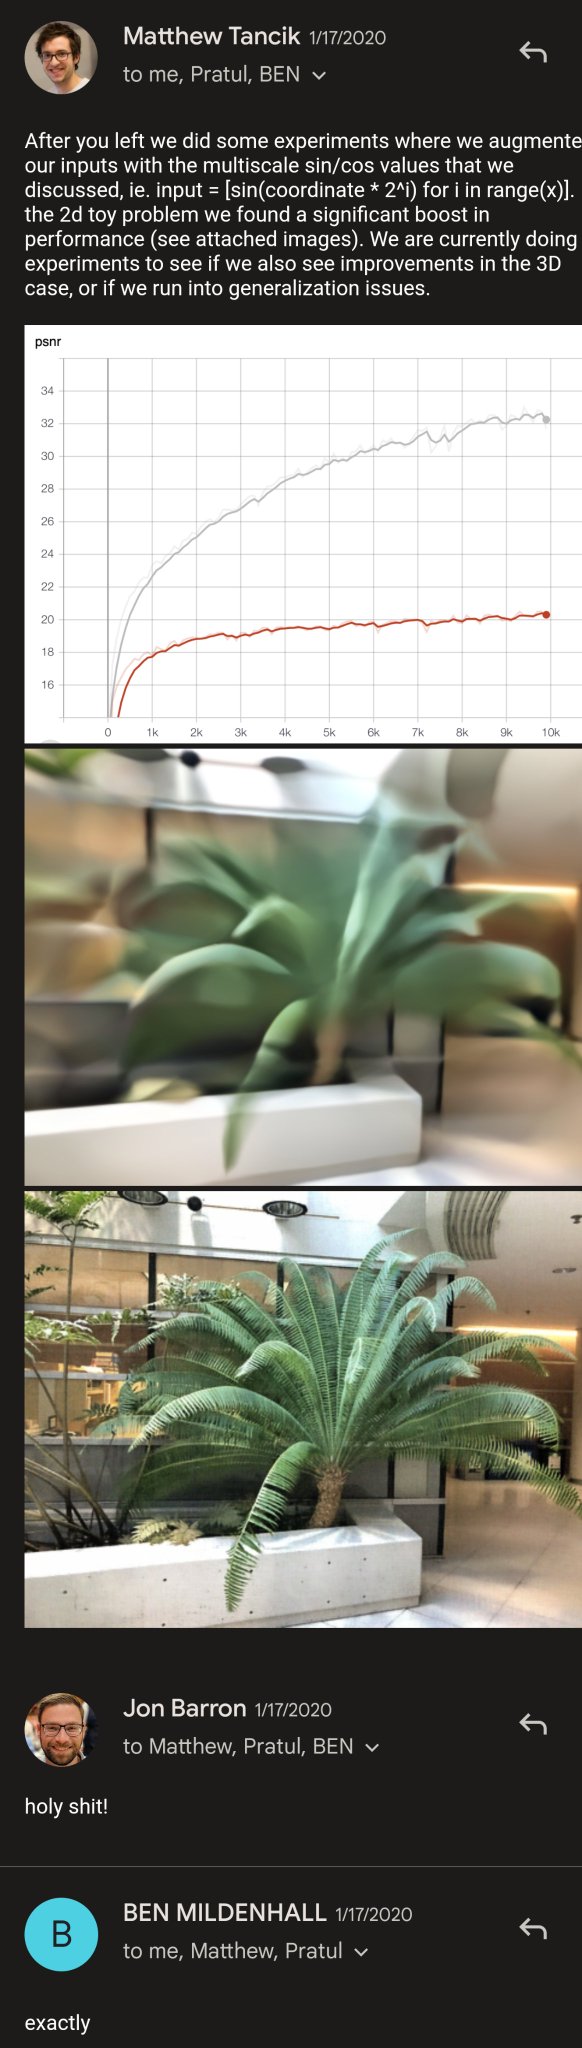
¡Feliz cumpleaños a NeRF! Una de las tecnologías favoritas de mi canal Cómo mola conocer estas pequeñas piezas de la historia del Deep Learning.
-
For embedding retrieval, hallucinating lies beats ‘I don’t know’
By
–
I love how this is a clear use case for hallucination. If the reason you’re generating an “answer” is merely to produce an embedding suitable for retrieving one, saying “I don’t know” is useless and confidently making up lies is better.