technological progress is the only thing that delivers real, sustainable economic growth
RESEARCH
-

Charles Babbage’s Difference Engine: Computing Pioneer
By
–
Happy birthday to Charles Babbage, who pioneered computing with his "Difference Engine." http://
bit.ly/1MvReDN -
Why Scaling Large Language Models Matters in AI
By
–
A estas tecnologías se le llaman Enormes Modelos del Lenguaje (LLMs) y si queréis saber por qué es tan interesante hacer a estas IAs cada vez más grandes, en este vídeo se explica muy bien 🙂
-
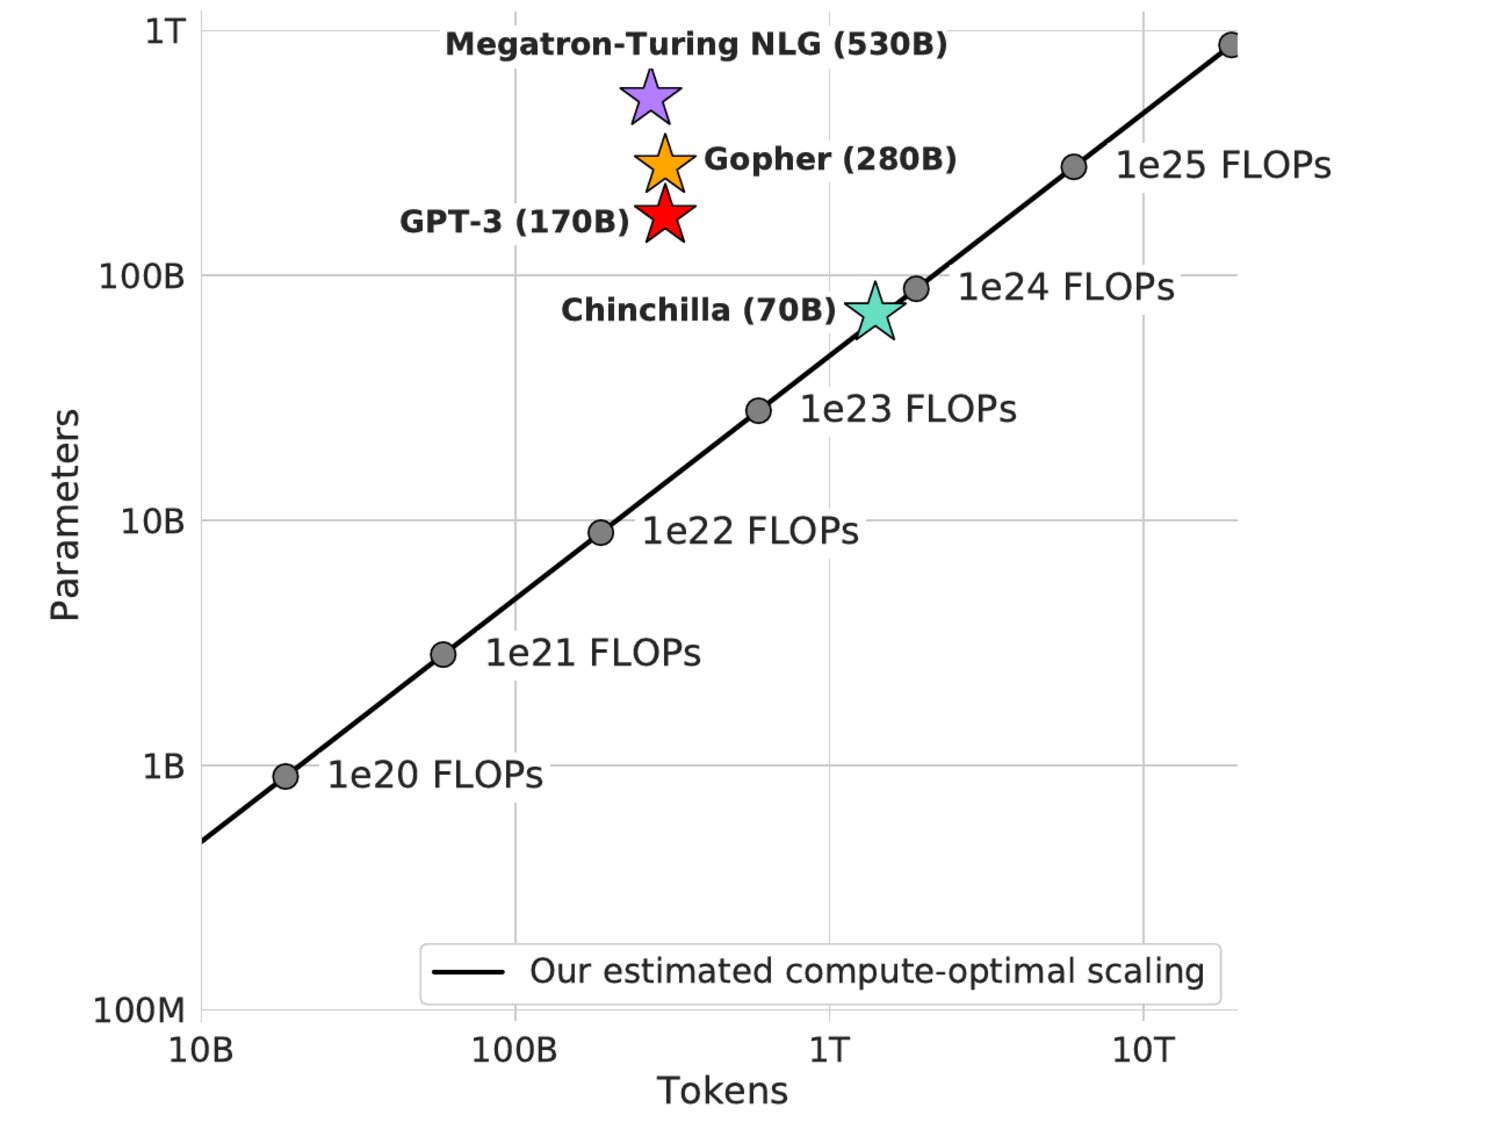
Chinchilla shows scaling laws matter more than model size
By
–
Y es que este año DeepMind con Chinchilla demostró que no hacía falta escalar tanto a estos Enormes Modelos del Lenguaje. Que GPT-3 todavía tenía margen de mejora para ser entrenado más y con más datos sin necesidad de hacerlos MÁS GRANDES. Así que el tamaño no es tan importante.
-
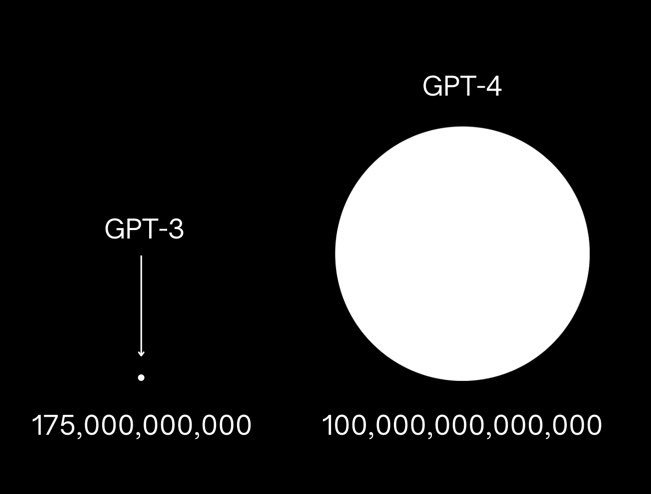
Future AI Models: 5x Larger than GPT-3 Predicted
By
–
Rumores hablan de esto: un modelo 500 VECES más grande que GPT-3. …pues no lo creo Si así fuera tendría miedo de tremenda bestia Pero creo que lo que vamos a ver es algo más "modesto" quizás un modelo 5 VECES mayor que llegue al BILLÓN de parámetros
-
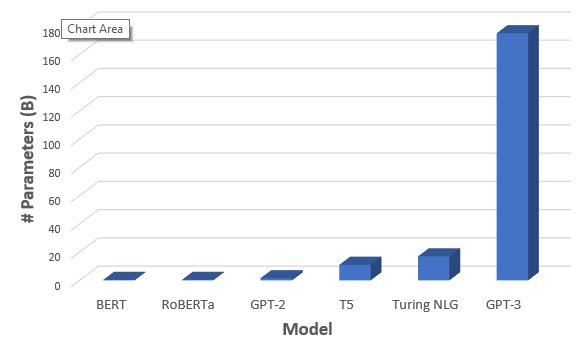
GPT-4 scaling potential beyond GPT-3’s 175 billion parameters
By
–
Si algo impresionó de GPT-3 fue cómo OpenAI logró escalar el tamaño de su modelo frente a sus predecesores. Respecto a GPT-2, la nueva versión aumentó su número de parámetros en >100 veces, hasta los 175 mil millones de parámetros. ¿Cuánto podría escalar GPT-4? ¿Qué pensáis?
-

GPT-4 curiosity sparked by Gary Marcus critique
By
–
Si algo ha despertado mi curiosidad por GPT-4 es leer este párrafo del blog de Gary Marcus, quien por normal general (y en este artículo no es la excepción) se sitúa en las antípodas de estos Enormes Modelos del Lenguaje. ¿Hay gente probándolo ya?
-
GPT-4: The Most Anticipated Deep Learning Model Yet
By
–
Desde que aprendimos el patrón GPT-2 -> GPT-3 -> …
la versión 4 de la familia GPT ha sido el modelo más anticipado de la historia del Deep Learning, y ahora mismo el hype está bastante alto. Se dicen cosas como estas -
Gradient Descent: Essential Optimization Algorithm for Machine Learning Models
By
–
Gradient descent – a crucial tool for anyone working in #machinelearning – is an optimization algorithm commonly used to train models and neural networks. IBM Master Inventor @martinrtp
, illustrates its utility: https://
ibm.co/3hH8zSm —-
#IBM #datascience #AI #ML -

Google’s 2023 PaLM AI Model with 560 Billion Parameters
By
–
Google’s 2023 AI project: Pathways Language Model (PaLM) claims to have 560 billion parameters, nearly 3x that of OpenAI’s GPT-3