Scaling Embeddings Outperforms Scaling Experts in Language Models
@_akhaliq
-
Benchmarking Spatial Intelligence of Text-to-Image Models
By
–
Everything in Its Place Benchmarking Spatial Intelligence of Text-to-Image Models
-
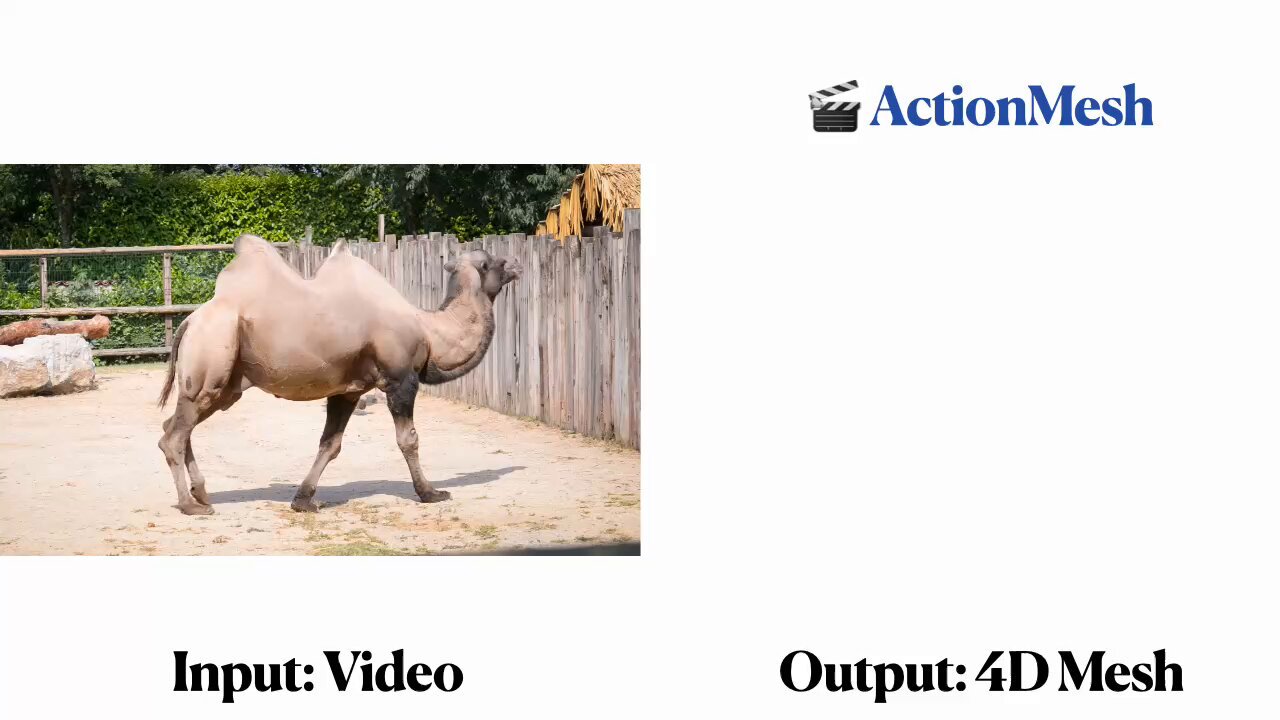
ActionMesh: Animated 3D Mesh Generation with Temporal Diffusion
By
–
ActionMesh
— AK (@_akhaliq) 30 janvier 2026
Animated 3D Mesh Generation with Temporal 3D Diffusion pic.twitter.com/WI22IJg3WRActionMesh Animated 3D Mesh Generation with Temporal 3D Diffusion
-
Spark: Dynamic Branching for Long-Horizon Agent Learning
By
–
Spark Strategic Policy-Aware Exploration via Dynamic Branching for Long-Horizon Agentic Learning
-
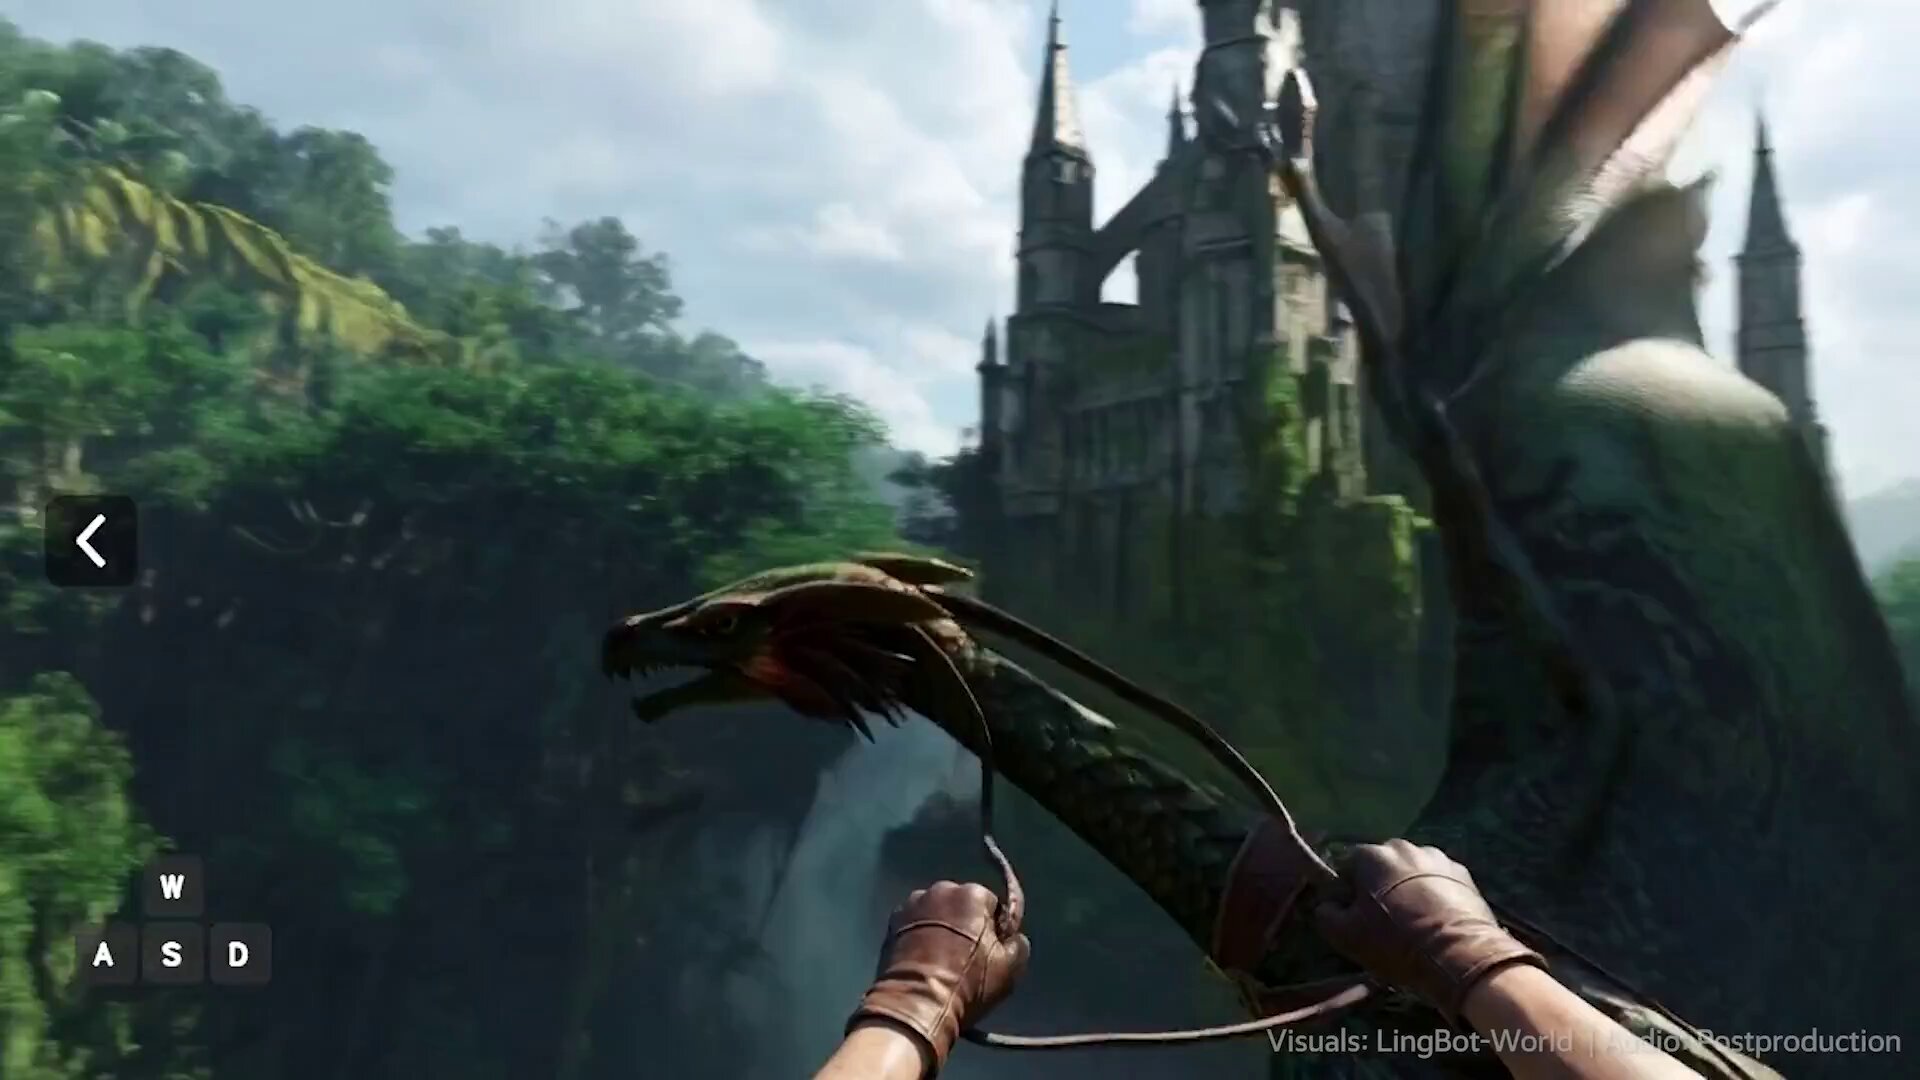
Advancing Open-source World Models
By
–
Advancing Open-source World Models pic.twitter.com/jDjv2k0Tft
— AK (@_akhaliq) 29 janvier 2026Advancing Open-source World Models
-
Youtu-VL: Unified Vision-Language Supervision Framework
By
–
Youtu-VL Unleashing Visual Potential via Unified Vision-Language Supervision
-
Visual Generation Enables Human-Like Reasoning via Multimodal Models
By
–
Visual Generation Unlocks Human-Like Reasoning through Multimodal World Models
-
AdaReasoner: Dynamic Tool Orchestration for Visual Reasoning
By
–
AdaReasoner Dynamic Tool Orchestration for Iterative Visual Reasoning
-
High-Sparsity Attention Tuning for Video Diffusion Transformers
By
–
SALAD Achieve High-Sparsity Attention via Efficient Linear Attention Tuning for Diffusion Transformer